网页爬虫
软件介绍
网页爬虫是一款面向普通安卓用户的轻量级网页数据采集工具,官方定位为“让每个人都能轻松抓取网页信息”。它把传统上需要编程基础才能完成的网页数据提取工作,封装成可视化操作界面,用户只需输入目标网址、框选需要的内容区域,即可把网页上的文字、链接、图片地址等结构化信息保存到本地。对于做市场调研、竞品监控、内容整理、价格比对的自媒体人和职场白领来说,网页爬虫省去了手动复制粘贴的重复劳动,把零散信息快速汇总成可用的表格数据。软件体积小巧,对设备性能要求不高,中低端安卓手机也能流畅运行,安装后无需复杂配置即可开始第一次采集任务。
核心功能亮点
可视化框选采集:
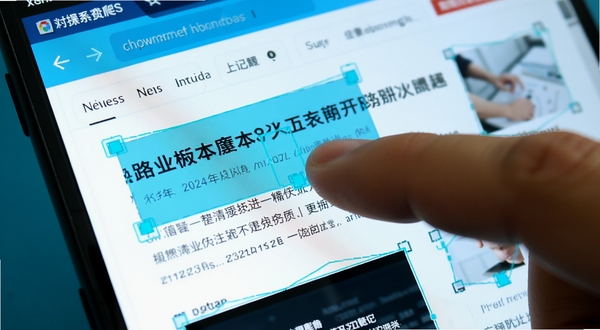
网页爬虫最大的特点是所见即所得的采集方式。打开目标网页后,软件会在页面上叠加一层选择层,用户用手指点选需要抓取的标题、价格、时间、正文段落等元素,软件自动识别对应的页面结构并生成采集规则。整个过程不需要写一行代码,也无需理解HTML标签含义,选错了可以随时撤销重选,对新手非常友好。
多页自动翻页:
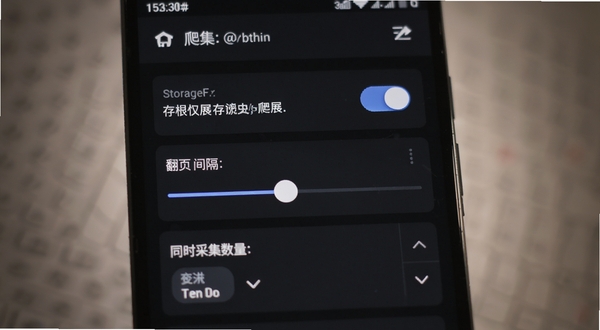
面对分页展示的列表页面,网页爬虫支持设置翻页规则。用户指定“下一页”按钮的位置后,软件会按照设定页数自动逐页加载并提取数据,把原本需要几十次手动点击的工作压缩成一次任务。采集过程中可以随时暂停查看进度,已经抓取到的数据不会丢失,适合整理电商评论、招聘信息、论坛帖子等分散在多页的内容。
数据导出与本地保存:
采集完成后,数据以表格形式呈现在软件内,支持按字段排序和简单筛选。用户可以把结果导出为CSV或文本文件,保存到手机存储中,再通过微信、邮件或数据线传到电脑上继续处理。所有数据默认只保存在本机,不上传云端,避免敏感信息外泄,这一点对处理内部资料的办公人群尤为重要。

任务管理与定时提醒:
网页爬虫允许把常用的采集规则保存为任务模板,下次遇到同类网页时直接调用,不用重复框选。对于需要持续关注的数据,可以设置定时提醒,到点后软件通知用户手动启动采集,帮助养成规律的信息收集习惯。任务列表清晰展示每个任务的字段数量、最近运行时间和数据条数,方便统一管理。
使用指南
网页爬虫的安装包体积不大,下载完成后点击安装即可。
移动端首次打开时,系统会提示授予存储权限,用于保存采集结果文件,建议选择“允许”,否则导出功能无法正常使用。
高危避坑:请勿在软件运行过程中强制关闭后台,否则当前未保存的采集进度会全部丢失,建议每完成一页采集就手动保存一次任务。
电脑端如需查看导出的CSV文件,用Excel或WPS打开时注意选择UTF-8编码,避免中文乱码。
优化技巧:采集长列表页面时,把翻页间隔设置为2至3秒,既能降低被目标网站限制的概率,也能减少手机发热。
部分网页内容由脚本动态加载,框选时如果发现元素无法选中,可以尝试在软件设置中开启“等待页面加载完成”选项,延长页面渲染等待时间。
温馨提示:采集到的数据请仅用于个人学习与内部整理,尊重目标网站的服务条款,不要高频次请求同一页面。
如果遇到软件闪退,先检查手机剩余存储空间是否低于500MB,清理缓存后重新打开;若问题依旧,可在站内搜索“网页爬虫 闪退修复”查看依赖组件安装说明。
运行卡顿时,关闭其他后台应用,并在软件设置中把“同时采集数量”调低至1,可明显改善流畅度。
黑屏问题多出现在安卓低版本设备上,建议升级系统或更换为配置稍高的设备使用。
权限设置方面,除了存储权限,网页爬虫不需要通讯录、位置等敏感权限,若安装时发现索要无关权限,请立即停止安装并从正规渠道重新下载。
精选同类应用
| 软件名称 | 功能优势 | 评分 |
| 数据采集助手 | 支持批量导入网址列表 | ★★★★☆ |
| 网页抓取器 | 正则表达式高级匹配 | ★★★★☆ |
| 信息提取工具 | 一键提取表格数据 | ★★★★ |
| 爬虫助手 | 定时自动采集任务 | ★★★★ |
| 网页快照 | 离线保存网页全文 | ★★★☆ |
用户问答专区
网页爬虫安全吗
网页爬虫本身不包含恶意代码,安装包为正规渠道打包,运行时只申请存储权限用于保存采集结果,不会读取通讯录、短信等隐私内容。需要注意的是,软件的安全性也取决于下载来源,建议从本站或官方渠道获取安装包,避免使用来历不明的修改版。采集到的数据仅保存在本机,软件不设云端同步功能,进一步降低了信息泄露风险。
网页爬虫怎么用
使用流程可以概括为三步:打开软件后输入目标网址并加载页面,在页面上点选需要采集的内容元素,确认字段后启动采集。采集完成后在结果页查看数据并导出。第一次使用建议先拿一个结构简单的网页练手,熟悉框选和翻页设置后再处理复杂页面。软件内的任务模板功能可以保存常用规则,后续重复使用能省下大量时间。
网页爬虫如何导出数据
采集任务结束后,进入结果列表页,点击右上角的导出按钮,选择CSV格式,软件会把当前任务的所有数据写入手机存储的指定文件夹。导出完成后会弹出文件路径提示,用户可以通过文件管理器找到该文件,再分享到电脑或其他应用。如果导出失败,优先检查存储权限是否开启以及剩余空间是否充足。
最新版更新日志
v1.0(2026-01-15)
【新增】可视化框选采集功能,支持文字、链接、图片地址三类字段提取,首次实现零代码采集;新增多页自动翻页规则设置,单任务最多支持连续采集50页;新增CSV导出功能,单次最多导出5000条记录。
【优化】页面加载等待时间由固定3秒改为可调节的1至10秒,适配不同网络环境;任务列表增加数据条数与最近运行时间显示,方便管理多个采集任务;安装包体积压缩约18%,降低中低端设备安装压力。
【修复】修复部分安卓12设备上框选层错位导致无法选中元素的问题;修复连续翻页超过20页时软件无响应需重启的缺陷;修复导出文件在WPS中打开出现中文乱码的编码错误;修复后台切换后任务进度丢失的异常。
详细信息
| 版本号 | v1.0 网页数据采集 |
| 软件语言 | 简体中文 |
| 软件类型 | 国产软件 |
| 授权方式 | 免费软件 |
| 文件大小 | 138KB |
| 运行环境 | Android |
| 更新时间 | 2026-10-27 |
相关软件