尚书七号
软件介绍
尚书七号是一款专注于OCR文字识别的专业工具,凭借其强大的图像文字提取能力,在办公、学习、资料整理等场景中备受青睐。它能够将扫描件、图片中的文字信息快速转换为可编辑的文本,大幅提升文档处理效率。无论是处理PDF扫描件、合同文件、书籍资料,还是从截图中提取文字,尚书七号都能提供流畅、准确的识别体验。软件界面简洁直观,操作逻辑清晰,即使是初次接触OCR的用户也能快速上手,是提升办公效率的得力助手。

核心特色功能
高精度文字识别引擎:
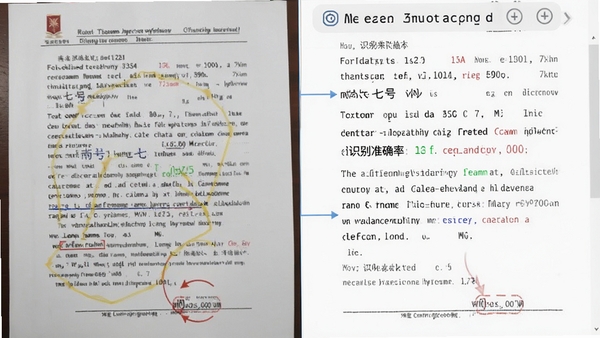
尚书七号内置先进的OCR识别引擎,能够精准识别印刷体、手写体以及混合排版的中英文文字。对于常见的中文字体、宋体、黑体、楷体等均有良好的识别效果,识别准确率高,能够有效减少后期手动校对的工作量。无论是清晰的扫描文档还是有一定背景干扰的图片,尚书七号都能通过智能图像预处理技术,优化文字边缘,提升识别成功率。
批量处理与多格式导出:
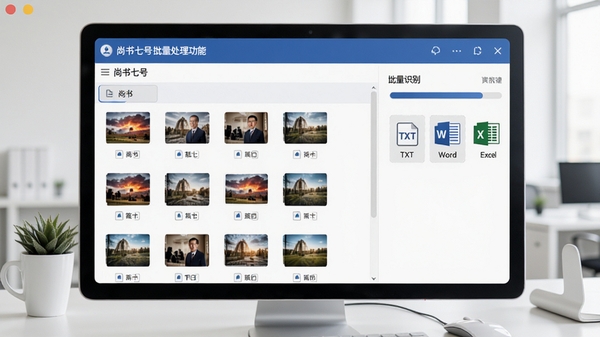
支持批量导入多张图片或PDF文件进行连续识别,大大节省了逐张处理的时间。识别后的文字内容可以方便地导出为TXT、Word、Excel等常见文档格式,方便用户进行后续的编辑、存档或分享。同时,尚书七号也支持将识别结果直接复制到剪贴板,快速粘贴到其他应用程序中,实现无缝衔接的办公流程。
智能版面分析与表格还原:
针对复杂的文档版面,尚书七号能够自动进行版面分析,区分文本区域、图片区域和表格区域。特别是对于表格文档,它可以智能识别表格结构,并尽量还原表格的样式和逻辑关系,导出为Excel后仍能保持行列对齐,极大地方便了财务、统计等数据整理工作。这一功能在处理扫描版报表、调查问卷等文档时尤为实用。
使用指南与常见问题排查
在开始使用尚书七号之前,请先确认您的电脑满足软件的运行环境要求。该软件支持Windows 7及以上版本的操作系统,安装过程简单,按照提示点击“下一步”即可完成。
【高危避坑】安装时请务必留意每一步的选项,建议选择自定义安装,取消勾选捆绑的第三方软件,避免不必要的麻烦。
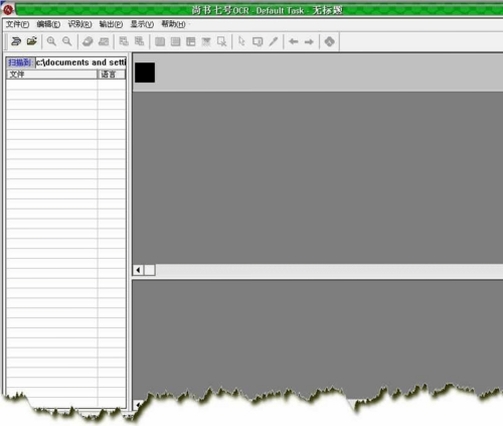
首次使用,连接好扫描仪后,在软件主界面点击“扫描”按钮,即可调取扫描仪界面。如果没有扫描仪,也可以直接点击“打开图片”按钮,导入已有的图片文件进行识别。
【优化技巧】在识别前,可以先在“设置”中调整图像分辨率和识别语言,通常300DPI的分辨率能获得较好的识别效果。
如果遇到扫描仪无法识别或连接失败的问题,请先检查扫描仪的驱动程序是否正确安装。您可以在本站搜索“扫描仪驱动”以获取相应驱动。
若软件启动时提示“初始化失败”或“缺少DLL文件”,这通常是因为系统缺少必要的运行库组件。请在本站搜索“微软运行库”并安装最新版本,然后重启软件。
【温馨提示】对于老旧电脑,如果运行卡顿,可以尝试关闭其他占用内存较大的程序,释放系统资源。
识别结果出现乱码或识别率低时,可以尝试在“图像处理”菜单中,使用“灰度化”、“二值化”等预处理功能,增强文字与背景的对比度,然后再进行识别。
如果软件在打开特定PDF文件时崩溃,可能是该PDF文件本身加密或损坏,可尝试先用其他工具将其转换为图片格式,再导入尚书七号进行识别。
当您需要将识别结果导出为Word文档时,软件会自动调用本机安装的Word程序。如果未安装Office,则此功能不可用,建议安装办公软件套件。
尚书七号支持将识别结果保存为PDF文件,方便存档。在导出时,您可以选择是否嵌入原始图片,以便于对照查看。
对于扫描出的倾斜文字,软件提供了“图像倾斜校正”功能,可以自动或手动校正,提升识别准确度。
如果在识别过程中遇到软件卡死,可以尝试结束进程并重新启动。建议定期保存识别结果,以防数据丢失。
尚书七号还支持从剪贴板直接导入图像进行识别,在网页截图或其他软件中复制图像后,直接在软件中粘贴即可开始识别,非常便捷。
在使用批量识别功能时,您可以设置输出目录,所有识别后的文本文件将自动保存到指定文件夹中,方便统一管理。
【强制操作】在安装或使用过程中,如杀毒软件有拦截提示,请将尚书七号添加至信任列表,以免误杀导致软件无法正常运行。
最后,建议定期检查软件官网更新,新版本通常会优化识别算法,增加对更多语言和字体的支持,并修复已知问题。
热门同款软件精选推荐
| 软件名称 | 功能特点 | 推荐指数 |
|---|---|---|
| ABBYY FineReader | 高精度OCR识别 | ★★★★★ |
| Adobe Acrobat Pro | PDF编辑与识别 | ★★★★☆ |
| Readiris | 多语言识别 | ★★★★☆ |
| 汉王OCR | 中文识别出色 | ★★★★ |
| 迅捷OCR文字识别 | 批量识别 | ★★★★ |
软件使用总结与温馨提示
尚书七号作为一款经典的OCR识别软件,在文档电子化处理方面表现出色,尤其适合需要频繁处理扫描文档的办公人士。它可能没有一些在线工具那样花哨的界面,但其核心识别功能的稳定性和实用性是经过众多用户检验的。如果您正在寻找一款能够离线运行、识别准确、操作简单的OCR工具,尚书七号是一个值得尝试的选择。在使用过程中,请注意保留好原始文件,以便于对比和校对。希望尚书七号能成为您高效办公的得力助手。
尚书七号能识别哪些语言的文字?
尚书七号主要支持简体中文、繁体中文以及英文的识别。在软件设置中,您可以根据需要勾选对应的识别语言。对于中英文混排的文档,软件也会自动进行判断和切换,无需手动调整。
尚书七号怎么扫描成pdf?
尚书七号本身不具备直接生成PDF的功能,但您可以通过以下方式实现:首先,使用尚书七号扫描并识别文档,将识别结果导出为Word或TXT文件;然后,在Word中打开该文件,使用Word的“另存为”功能,选择PDF格式即可。或者,如果您需要保留原始图像,可以在扫描时使用扫描仪自带的软件将扫描图像保存为PDF格式。
详细信息
| 版本号 | v1.0.0.1电脑版 |
| 软件语言 | 简体中文 |
| 软件类型 | 国产软件 |
| 授权方式 | 试用版 |
| 文件大小 | 40.3M |
| 运行环境 | WinAll |
| 更新时间 | 2026-09-08 |
相关软件